

Des modèles d'IA de pointe tournent sur un serveur sans GPU vieux de 14 ans
Un passionné parvient à faire fonctionner GLM 5.3 Flash, Qwen 3.8 Flash et Qwen 3.8 27B sur un Dell PowerEdge R720 sans carte graphique, à environ quatre tokens par seconde, remettant en question l'idée qu'il faut nécessairement du matériel coûteux pour exécuter des grands modèles de langage en local.
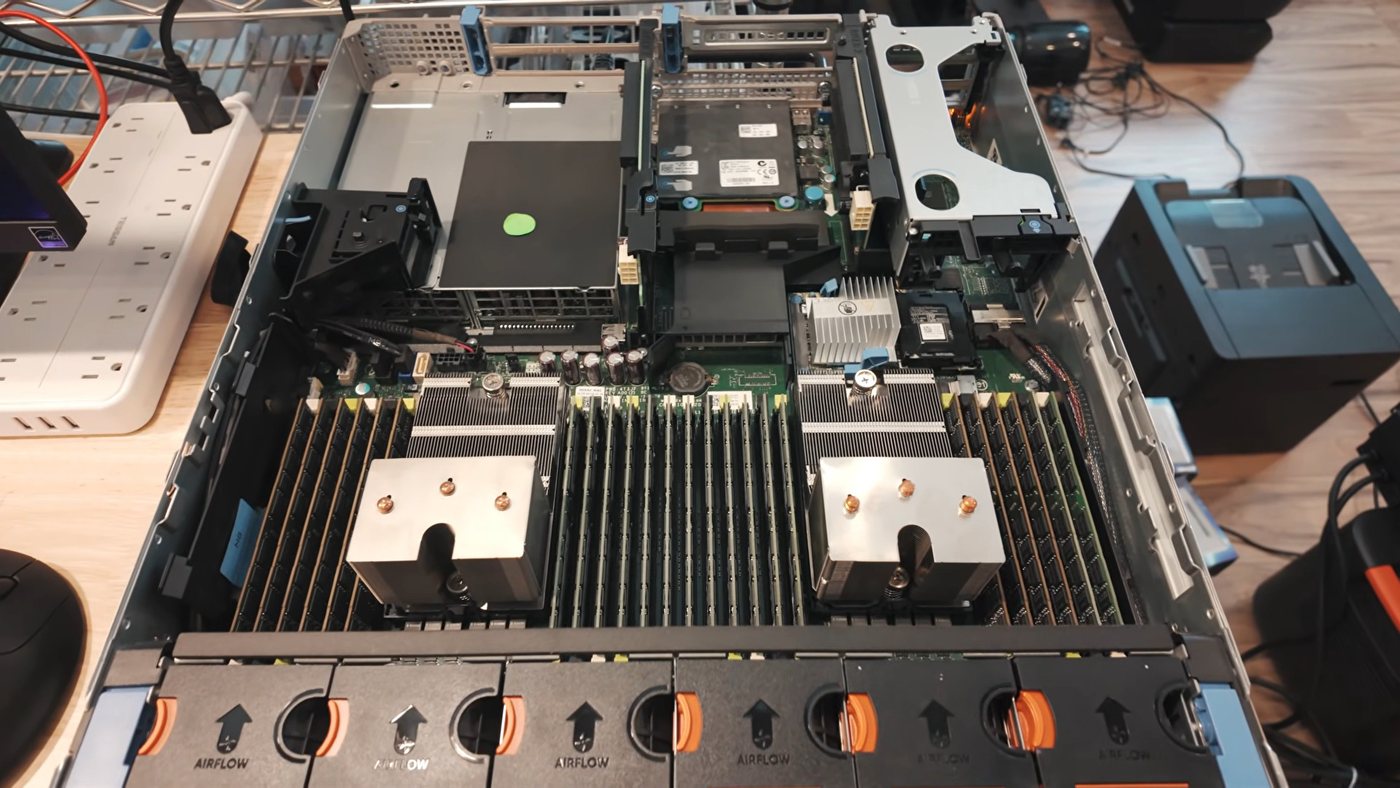
Faire tourner les grands modèles de langage les plus récents sans carte graphique dédiée et sur une machine vieille de quatorze ans : c'est le défi qu'a relevé un passionné connu sous le pseudonyme de MattMo. Dans une vidéo récente, il montre GLM 5.3 Flash, Qwen 3.8 Flash et Qwen 3.8 27B en fonctionnement sur un serveur Dell PowerEdge R720 équipé de deux processeurs Xeon, sans aucun GPU. La performance est modeste — environ quatre tokens par seconde au maximum — mais elle suffit à remettre en cause l'idée reçue selon laquelle seuls des équipements très coûteux permettraient d'exécuter des modèles d'IA de pointe en local.
Le secret de cette configuration tient à la mémoire vive. Le serveur embarque 348 Go de DDR3, une quantité qui permet de charger les modèles les plus volumineux directement en mémoire système. Les deux processeurs Xeon offrent en revanche un total de vingt threads seulement, ce qui constitue le principal goulot d'étranglement. Ces puces anciennes sont également dépourvues de certaines instructions qui auraient pu accélérer les calculs. Résultat : la génération de texte reste lente, avec un débit plafonné autour de quatre tokens par seconde, très loin des performances d'une carte graphique moderne.
Pour MattMo, cette lenteur n'est pas nécessairement rédhibitoire. Il souligne que certains usages, notamment le traitement par lots, peuvent se satisfaire d'un tel débit. La démonstration s'adresse aussi à un public particulier : les amateurs qui possèdent déjà ce type de serveur dans leur laboratoire personnel. L'intersection entre les besoins de traitement par lots et la possession d'une machine de cette génération reste sans doute étroite, mais elle existe. Pour ceux qui voudraient acquérir un tel équipement, le coût sur le marché de l'occasion est estimé à environ 600 dollars, un montant modeste comparé à l'achat d'une carte graphique haut de gamme.
Cette expérience s'inscrit dans un intérêt croissant pour l'exécution locale des modèles d'IA, motivé par des préoccupations de confidentialité ou par simple curiosité technique. Elle montre que la barrière matérielle n'est pas aussi absolue qu'on le pense souvent. MattMo précise toutefois que les modèles plus récents pourraient bénéficier d'optimisations futures pour améliorer les vitesses, sans qu'il faille espérer des conversations en temps réel avec une intelligence artificielle de science-fiction. En attendant, cette démonstration dépasse largement les bricolages sur des machines obsolètes, comme les modèles réduits exécutés sur des consoles portables ou des ordinateurs des années 1980.
